阿里云服务器codex网络问题修复
摘要
完整记录一次修复服务器网络问题的过程,同时也是提供一个tailscale和阿里云VPC内网DNS冲突的解决方案。
前言
我在服务器配置好 tailscale 后,原本正常工作的 codex cli 突然无法连接到网络。这个时候我还没有意识到是 tailscale 的问题,尽管现在复盘一下看起来好明显(刚刚配置好一个网络相关的服务,网络就突然不通了,还能是什么原因)。但是当时晚上我头脑不是很清醒,已经忘了刚刚配置了 tailscale,甚至还怀疑是中转站或者阿里云的网络问题。于是我开始了漫长的排查过程。
Reconnecting... waiting for network
Connection failed: error sending request
排查过程
找到问题到底出在谁身上
首先,我先测试了一下使用其他设备访问 api 是否正常,发现仍然可以正常使用。这说明中转站提供的 api 本身应该是能够正常访问的。
然后,我尝试重启 codex,毕竟没有什么方法比重启更高效了。重启若干次后,问题依旧存在。
我开始怀疑可能是服务器网络出现问题了。由于 ssh 连接正常,阿里云控制台的检测数据也没出现什么问题,我决定先绕过 codex,自己 curl 一下 Base URL。
curl -v 中转站的BaseURL
结果:
* Could not resolve host: 中转站的BaseURL
* Closing connection
curl: (6) Could not resolve host: 中转站的BaseURL
说明应该确实不是 codex 的问题,请求卡在了 DNS 解析上。于是我手动指定了一个 DNS 服务器:
$ nslookup 中转站的BaseURL 223.5.5.5
Server:         223.5.5.5
Address:        223.5.5.5#53

Non-authoritative answer:
Name:   中转站的BaseURL
Address: xx.xx.xx.xx
与之对比,若不指定:
$ nslookup 中转站的BaseURL
;; communications error to 127.0.0.53#53: timed out
看一下系统当前的 DNS 配置:
$ cat /etc/resolv.conf
# 此处省略若干行
nameserver 127.0.0.53
options edns0 trust-ad
search taile15594.ts.net
Ubuntu 上 127.0.0.53 是 systemd-resolved 的本地 DNS Stub,我接着检查服务:
systemctl status systemd-resolved --no-pager
Active: active (running)
Status: "Processing requests..."
再看看 53 端口:
$ sudo ss -luntp | grep ':53'
udp   UNCONN 0      0                       127.0.0.54:53         0.0.0.0:*    users:(("systemd-resolve",pid=495,fd=16))
udp   UNCONN 0      0                    127.0.0.53%lo:53         0.0.0.0:*    users:(("systemd-resolve",pid=495,fd=14))
tcp   LISTEN 0      4096                    127.0.0.54:53         0.0.0.0:*    users:(("systemd-resolve",pid=495,fd=17))
tcp   LISTEN 0      4096                 127.0.0.53%lo:53         0.0.0.0:*    users:(("systemd-resolve",pid=495,fd=15))
也就是说:
- systemd-resolved 没死;
- 53 端口也正常监听;
- 但是 DNS 查询就是没有结果。
我终于决定看看是不是 tailscale 的问题,于是我继续使用重启大法,结果没有任何效果。我只能先试着停掉 tailscale 服务:
sudo systemctl stop tailscaled
sudo systemctl restart systemd-resolved
此时,我再次尝试 curl Base URL,发现可以正常访问了。至此,我终于确认问题出在 tailscale 上。
找到问题的根源
resolvectl status
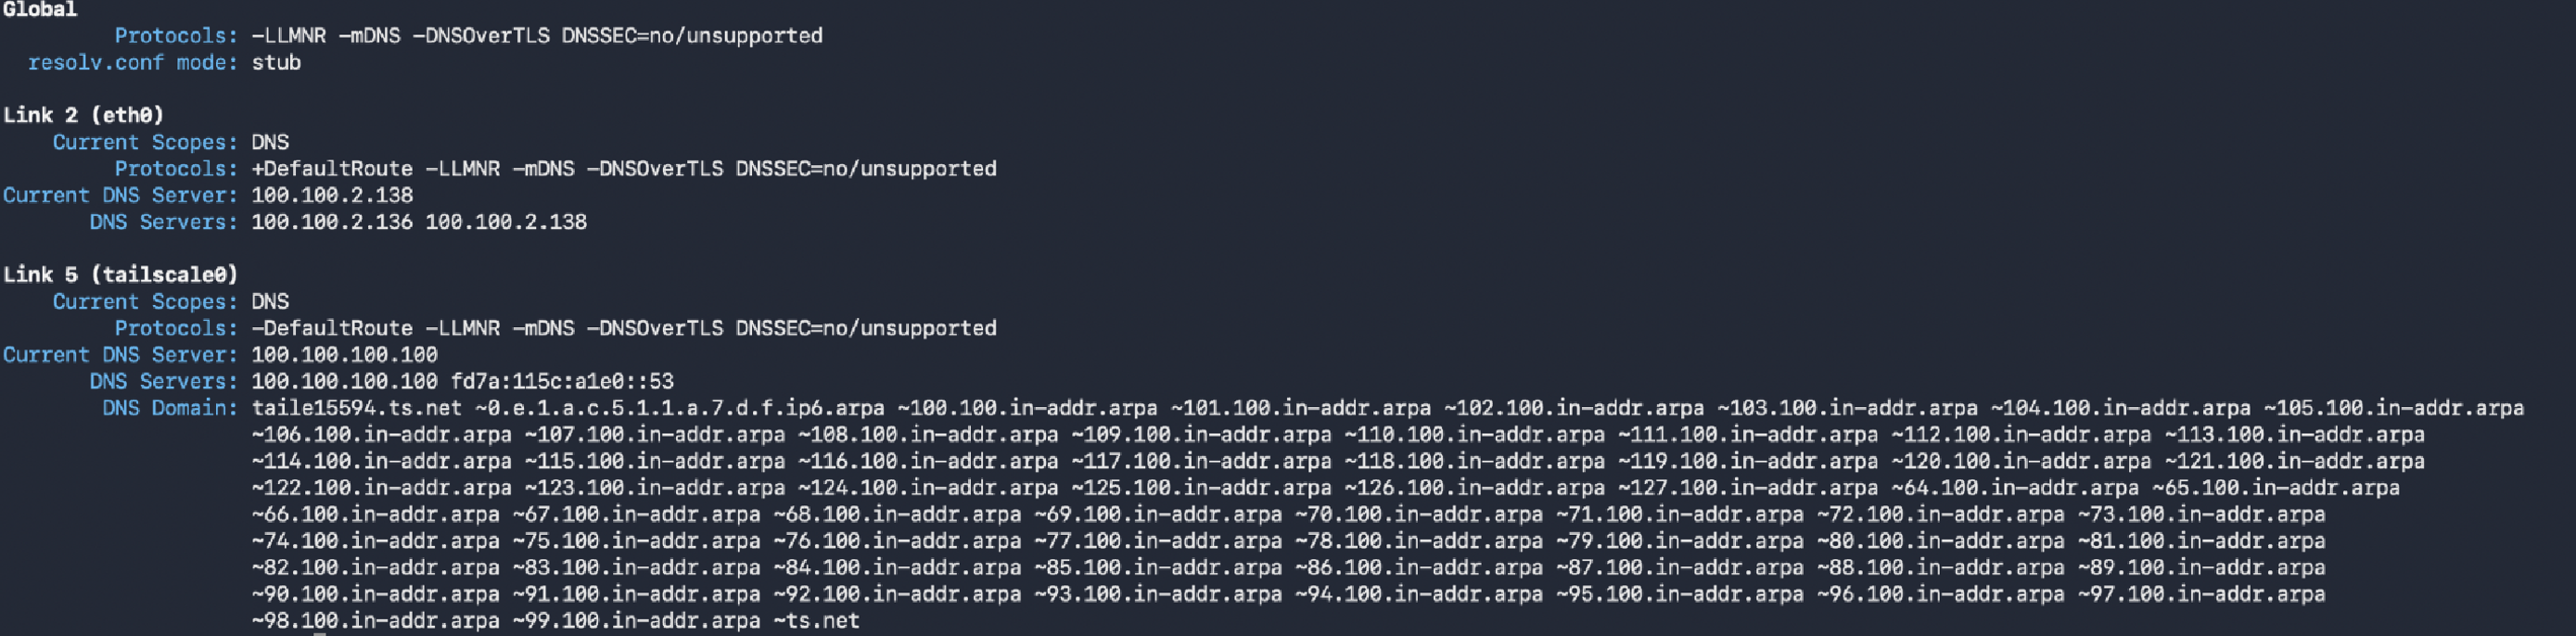
eth0 的 DNS 是:
100.100.2.136
100.100.2.138
这正是阿里云 ECS 默认的 VPC 内网 DNS。问题是 Tailscale 使用 100.64.0.0/10 作为自己的 IPv4 CGNAT 地址池。真正致命的是:Linux 上 Tailscale 默认会加一条防火墙规则,大意是:
如果数据包源地址属于 100.64.0.0/10 但却不是从 tailscale0 接口进来的 → DROP
这是 tailscale 防止别人伪造 tailscale IP 的安全机制,官方文档也明确说明了这一点。
所以这一切就很好理解了,这是 tailscale 和 阿里云 VPC 内网 DNS 冲突导致的乌龙。
解决
知道原因之后,这个问题并不难解决。我这台机器并不需要依赖阿里云的 PrivateZone 等 VPC 私有 DNS 功能,所以最直接的办法就是不再使用 100.100.2.136/138 作为系统 DNS。
我的服务器使用 Netplan,因此单独增加一个配置:
network:
  version: 2
  ethernets:
    eth0:
      dhcp4-overrides:
        use-dns: false
      nameservers:
        addresses:
          - 223.5.5.5
          - 223.6.6.6
随后
sudo chmod 600 /etc/netplan/99-custom-dns.yaml
sudo netplan generate
sudo netplan try
值得注意的是这里并不是禁用 DHCP,只是不接受 DHCP 下发的 DNS。IP 地址和网关这些仍然照常通过 DHCP 获取。因为是在远程服务器上操作网络配置,我没有直接 netplan apply,这样即使配置有问题导致 SSH 断开,没有手动确认的话也会自动回滚。
最后重新测试,全部恢复正常。
后记
感觉我经常被一个简单的问题缠上好久,然后发现成因其实很简单。还好有 ai 大人帮我一起排查,要是在前 llm 时代,我估计我可能要抓狂(这次还好,第二天仔细回忆一下不难通过问题产生的时间节点反推出是 tailscale 导致的)。希望这篇文章能帮到遇到类似问题的人。
本方案的局限性
这里采用的方案是直接将系统 DNS 从阿里云默认的 100.100.2.136/138 换成公共 DNS,优点是简单直接,但也有一个明显的限制:如果机器需要使用 PrivateZone、ECS 私网域名等依赖阿里云内网 DNS 的功能,这些解析可能会失效。
更完整的做法应该是保留阿里云默认 DNS,同时针对 tailscale 的 100.64.0.0/10 防火墙规则做例外处理。只是对于单纯跑公网服务、API 和 tailscale 组网的机器来说,直接更换 DNS 已经足够省事。